小論文も、総合問題も。 書いた分だけ、伸ばす。
医学部・AO・総合型の小論文から、早稲田政経・慶應SFCの「総合問題」まで。 書いた答案を5軸100点・約30秒で採点し、弱い軸を次の練習に変えます。 過去問が少ない入試には予想問題「未来問」も出します。代筆はしません。
クレジットカード不要 · 登録1分 · 毎月3回まで無料
iPhone・iPad アプリ(無料)を App Store で見るなぜ、小論文対策は独学で行き詰まるのか?
演習量・採点の物差し・評価の厳しさ ── 独学の小論文対策には3つの壁があります。
過去問が年2〜3本しかない
志望校の過去問は年に2〜3本しか出ません。市販の問題集は志望校の傾向に必ずしも合致せず、似た傾向の問題で何度も練習する手段がない。演習量そのものが作れないのが最大の壁です。
点数が分からないまま書いている
書いても、今の答案が何点なのかが分からない。「論理が弱い」「もっと根拠を」── 漠然としたフィードバックでは、次に何を直せばいいかが見えず、量を書いても伸びにくい。
汎用AIの採点では、本番で初めてギャップに気づく
汎用AIで「合格圏内」と表示されても、入試本番では評価が大きく下がるケースがあります。練習段階で「正しい厳しさ」の評価を受けないと、本番で初めて自分の実力を知ることになります。
EssAIの設計思想
「甘く励ます」より「実力を正しく伝える」── それが最短で合格に近づく道。
教育用途で Gemini を採用
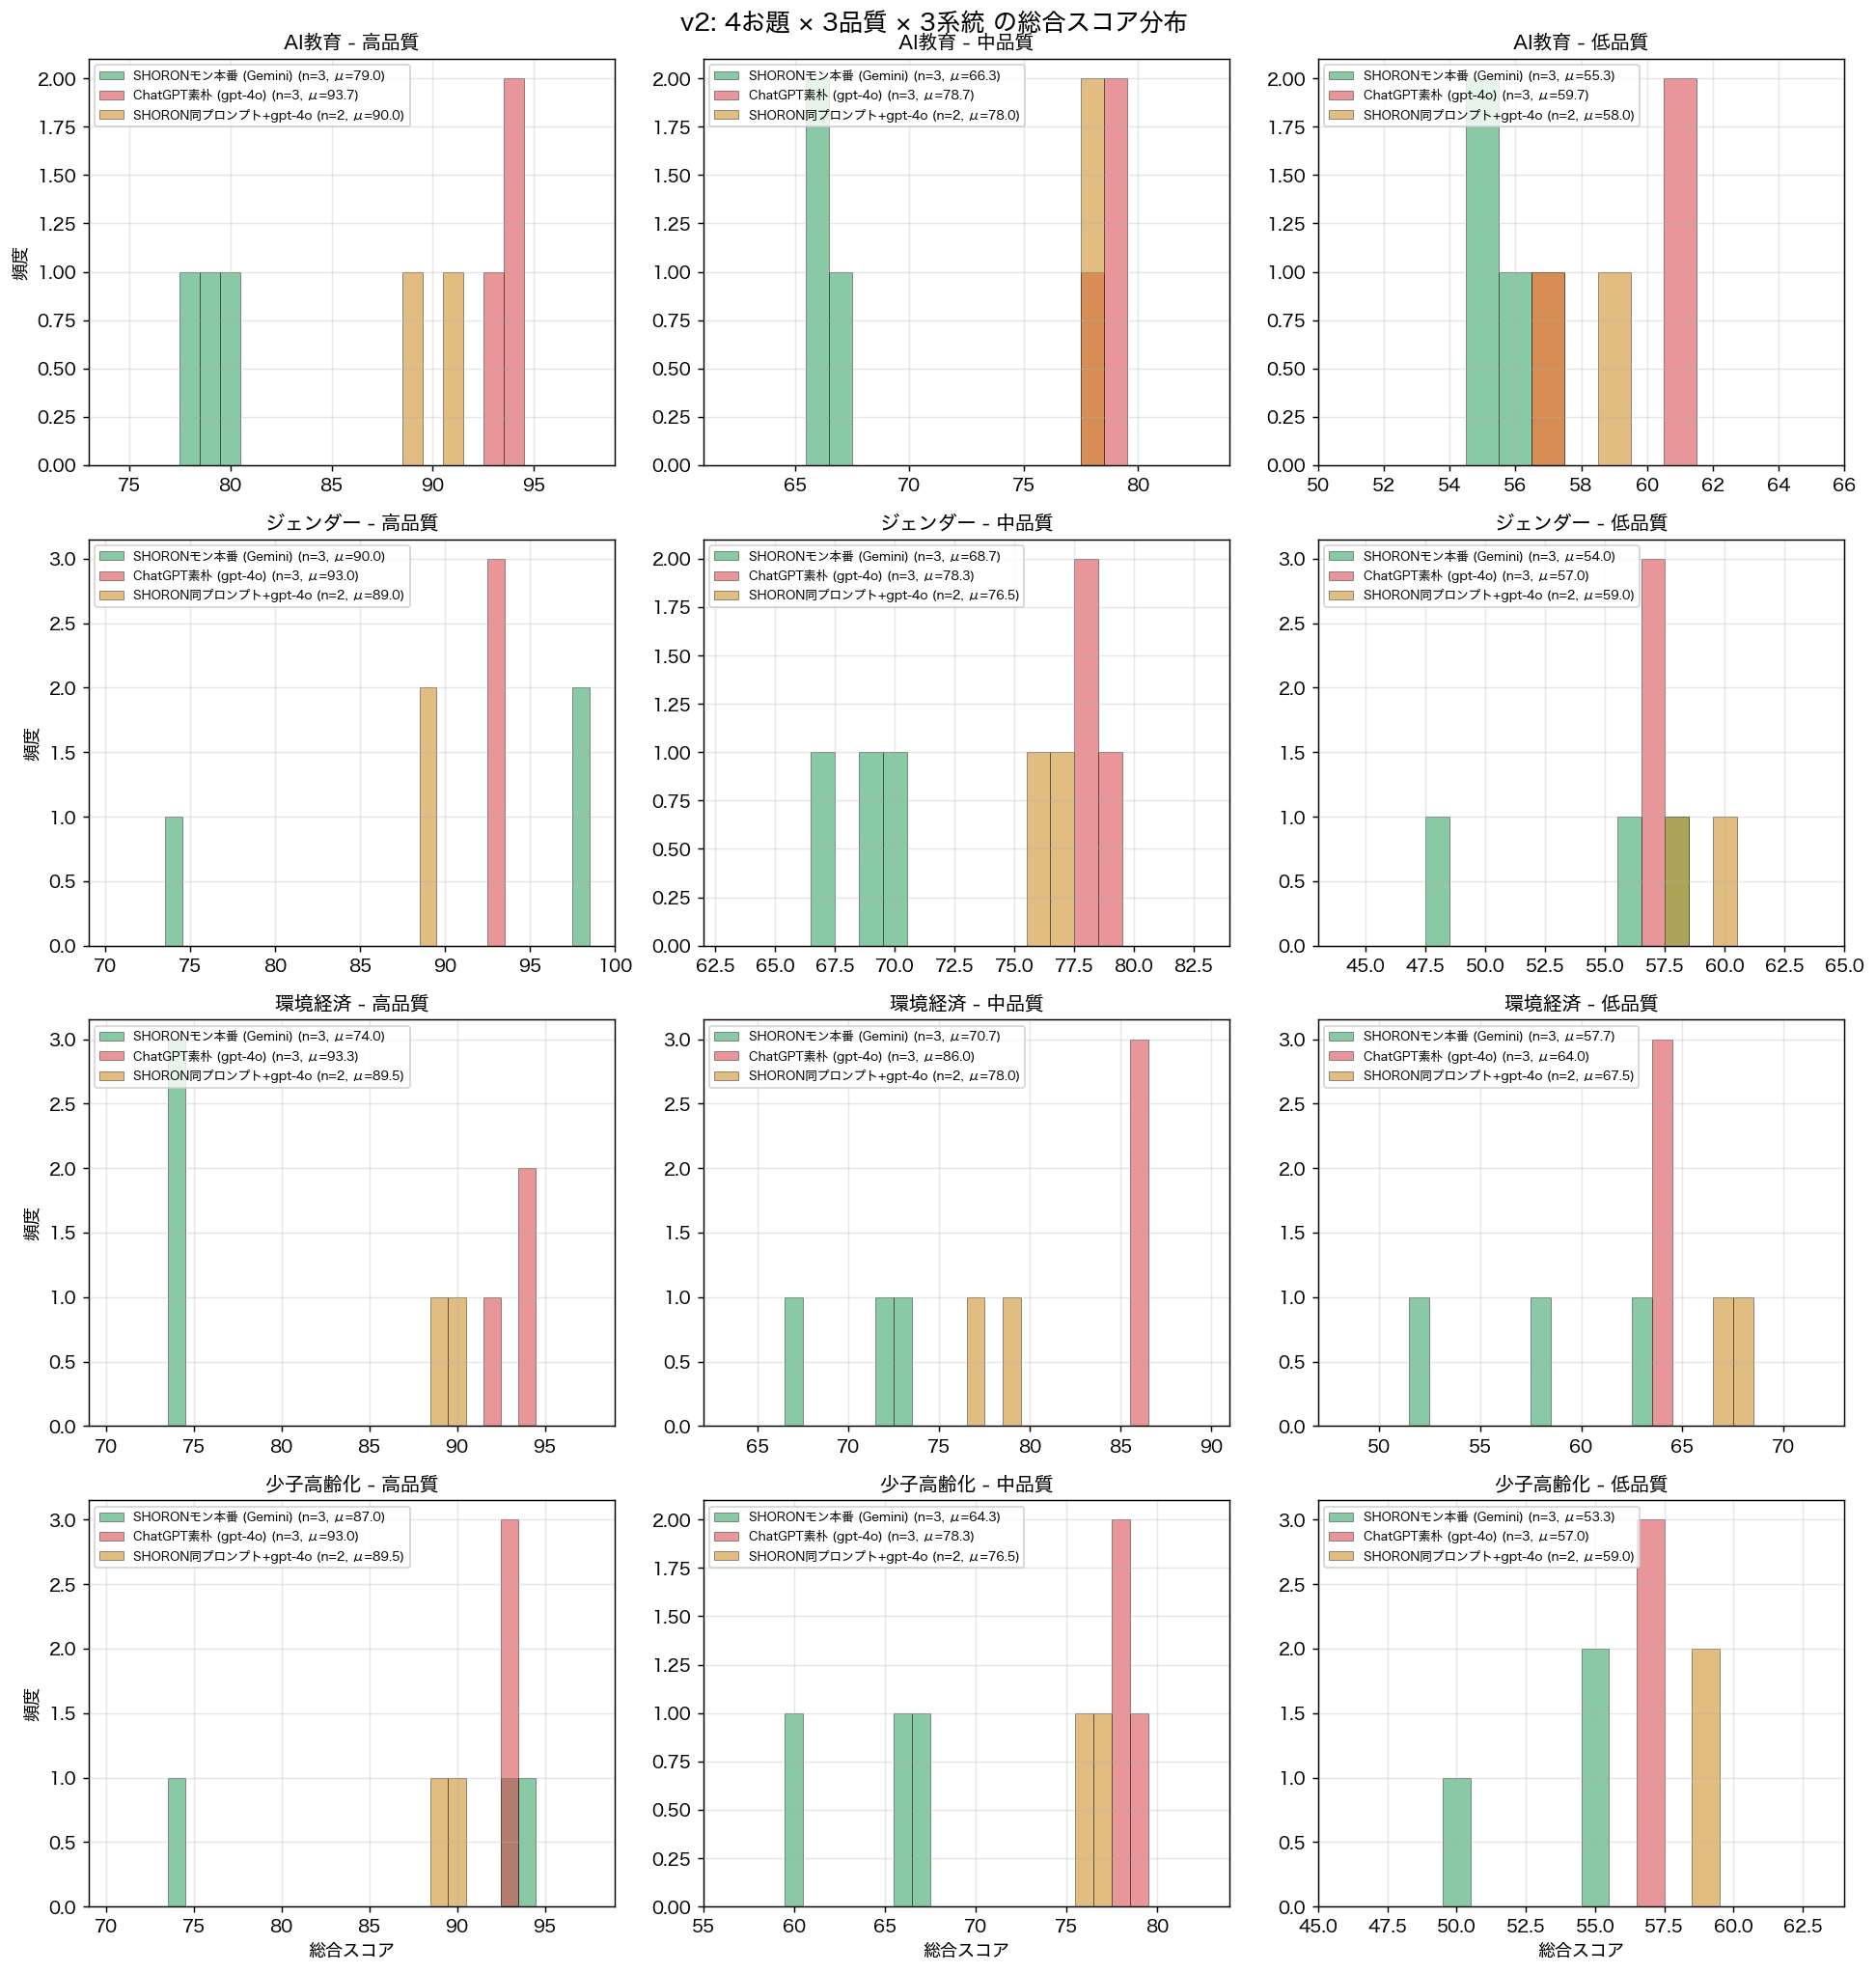
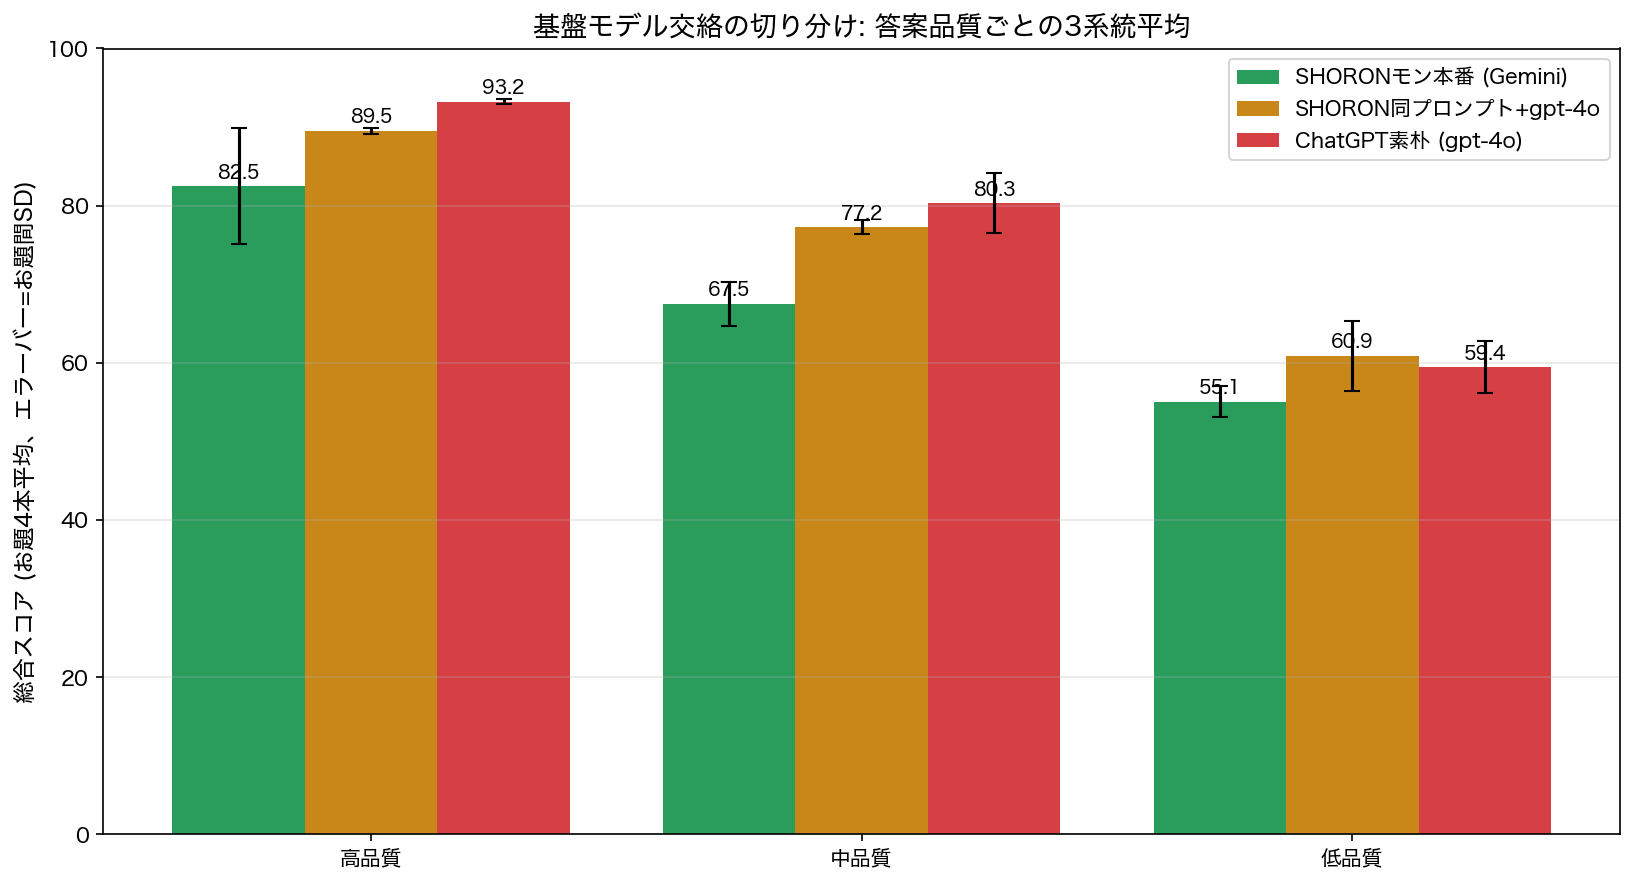
当社実測で、ChatGPT (gpt-4o) は中品質答案を約 +13点甘く採点する傾向が判明しました (n=36, p<0.001)。EssAIは教育用途に向く Gemini を選択し、入試本番に近い厳しさで評価します。
5軸独立採点で精緻なフィードバック
論理構成・根拠・表現力・課題適合性・独自性の5軸で個別採点。各軸ごとの具体的な改善点と「次のグレードに上げるには何が必要か」を毎回明示します。
批判的対話で弱点を深掘り
「その前提、本当に検討しましたか?」と答案の弱点を突くAI対話。対話を通じて主張を深め、反論を想定する力を鍛えます。
EssAIの独自機能
採点だけでなく、志望校特化の演習・成長可視化まで一つのサービスで。
未来問AI生成
志望校の過去問 (写真・PDF) を登録するだけで、AIが「その大学が問う思考スキル」を抽出し、同等のスキルを訓練できる予想問題を自動生成。第三者AI (Claude Sonnet) の盲検評価で **思考スキル一致度 8.37 / 10**、88.2% の問題で高水準 (8点以上) を達成、全 trial で実用合格水準 (5点以上) を達成しました (n=17, 6学校×3trial)。
習熟度に合わせて解説量が変わる
4段階。始めたばかりの人には5軸すべての詳しい解説と書き直し例を出し、書ける人には解説を減らして自分で振り返る形へ切り替えます。同じ画面がずっと続くことはありません。
習慣化バッジ & 成長グラフ
字数マスター・テーマ制覇・カムバックなど9種以上のバッジで学習継続をサポート。スコア推移グラフで5軸の成長を可視化し、スランプや偏り傾向も自動検知します。
こんな受験生のために
総合型・学校推薦・医学部・看護・公務員・就活ESまで幅広く対応
慶應SFC志望
高校3年生 · 総合型選抜
医学部志望
高校3年生 · 医学部小論文
東大学校推薦型志望
高校2年生 · 学校推薦型選抜
早稲田・政治経済志望
高校3年生 · 総合型選抜
看護学部志望
高校3年生 · 看護・医療系
地方公務員志望
大学3年生 · 公務員論文
開発者より
「志さえあれば、誰でも」を、
当たり前にしたい。
早稲田に入って、友人たちを見て気づいたことがあります。多くが関東出身で、親は社長や一流企業勤め、中高一貫——みんな大好きな友人だけど、なんだか平等じゃない気がしました。
多様性のために導入されたはずの総合型・AO・小論文も、いざ対策しようとすると専用の塾が要る。塾代は高い。そもそも、地方には対策できる塾が近くにないことも多い。実際、僕の地元にもほとんどありませんでした。
Claude Code でこのアプリを作りながら、こうも思いました。AI で知識やスキルが均質化していくこれからの時代こそ、多様なバックグラウンドを持つ人が平等に機会を得て、それぞれの場所でテクノロジーを活かしていくことが、いちばん社会のためになるはずだと。
だから作りました。地方でも首都圏でも、お金があってもなくても、誰かだけが有利にならない。志があれば、誰もが機会を得られて、その機会を活かしきれる——そんな社会のために。小論で「受かるため」の対策を、そして奨学金サポートで「通い続けるため」の力を、全員に届けたい。
— 開発者 / 早稲田大学政治経済学部
有料プランを検討する前に ── 登録した志望校 × あなたの答案を、どんな厳しさで採点するのか。実測データで確認できます。
料金プラン
無料プランから始めて、必要に応じてアップグレード可能です。
フリー
¥0
月3回採点・全機能
シーズンパス
¥3,800/3ヶ月
無制限採点・3ヶ月ごとに自動更新
スタンダード
¥1,480/月
まず1ヶ月だけ・無制限採点
よくあるご質問
Q.総合問題は受けません。小論文だけでも使えますか?▼
はい。採点・批判的対話・模範答案・習熟度に応じた解説は、すべて小論文だけで完結します。総合問題向けの機能(出題型の判定・未来問)は使わなくて構いません。医学部・AO・学校推薦型の小論文で使っている方が中心です。
Q.ChatGPTで採点してもらえば十分ではないですか?▼
当社実測で、ChatGPT (gpt-4o) に「100点で5軸採点して」と依頼した場合、中品質答案を平均 +12.83pt 甘く採点する傾向が判明しています (Cohen's d=3.78, p<0.001)。「ChatGPTで75点」が、EssAIでは62点相当になることがあります。入試本番に近い厳しさで採点したいなら、教育特化のEssAIをご利用ください。
Q.採点の信頼性はどのくらいですか?▼
4お題×3品質×3系統=n=36試行で検証しています。検証プロトコル・生データ (CSV)・統計分析スクリプトをすべて開示請求できます (sakumon2026@gmail.com)。第三者機関・研究者による再検証を歓迎します。
Q.未来問は本当に志望校の傾向を捉えられているのですか?▼
早稲田政経・東大推薦・慶應SFC・国家公務員総合職など公式公開された実際の過去問 6 学校セットで検証しました。当社採点モデル (Gemini) と独立した第三者AI (Claude Sonnet) による盲検評価で、「志望校が要求する思考スキルとの一致度 (skill_match)」が平均 8.37 / 10、88.2% の問題で 8 点以上を達成、全 trial で実用水準 (5 点以上) を達成しています (n=17 trial)。「テーマの予想」ではなく「思考スキルの再現」を品質指標としているため、過去問で問われていないテーマでも、その大学が求める思考の型を確実に訓練できます。
Q.検証規模が n=17 と少なくないですか?▼
ご指摘の通り現在の検証はパイロット規模です。2027年度内に n=50+ への拡張検証を予定しており、データの濃い 3 校追加・各校 5-7 trial へ拡張します。現時点でも (1) skill_match 8.37 / 10、(2) 全 17 試行で 5 点以上を達成、(3) 当社採点モデル (Gemini) と独立した第三者AI (Claude Sonnet) による盲検評価で自社バイアスを排除、という事実は確認できています。詳細な検証スクリプト・生データは開示請求対応です。
Q.無料プランでどこまで使えますか?▼
月3回まで全機能 (5軸採点・批判的対話・知識フィードバック・未来問演習) が使えます。クレジットカード登録は不要、登録1分で開始できます。
Q.志望校の過去問は写真でアップロードできますか?▼
はい、写真・PDF (最大50MB) でアップロード可能です。AIが自動でOCR読み取りし、大学・学部・年度も自動入力されます。
Q.スマートフォンだけで使えますか?▼
はい。iPhone・iPad は App Store の無料アプリ(EssAI)が使えます。ブラウザでも全機能が動くので、Android や PC からはそのままご利用ください。
代筆しません宣言
文部科学省が生成AIの利用方針を示し、AI検知が広がる時代に、「代わりに書くAI」は不正リスクそのものです。
EssAIは答案を代筆しません。書く力を測り、鍛える側のAIです。
本番の会場でひとりで書き切る力だけが、あなたを合格させます。
保護者の方へ
「うちの子、AIに過大評価されていない?」への回答
ChatGPT等の汎用AIで採点すると、生徒のスコアが実態より12〜13点甘く出る傾向があります (当社実測 n=36)。 生徒が「75点取れた」と思っていても、本番採点基準では62点相当である場合があります。 EssAIは、受験現場に近い厳しい基準で採点します。 また、答案の代筆は一切行いません(代筆しません宣言)。
保護者向け資料を請求する →設計の根拠
どの研究の、どの知見を、どこに実装したか
「AIだから効く」とは考えていません。作文指導には数十年分の実証研究があり、 EssAIの演習工程はそこから降ろしています。何を根拠にしたかを公開します。
本論の前に要約を書かせる
演習の第2工程作文指導のメタ分析で、要約指導は効果量 0.82。課題文型の小論文は要約が構造的に前提になるため、本論の前に工程として独立させた。要約には点数をつけず、「拾えた要点/落とした要点」だけを返す — 点数を主にすると、生徒が点数の最適化に向かうため。
Graham, S., & Perin, D. (2007). Writing Next. Carnegie Corporation.要約に「削除→選択→一般化→創出」の段階を置く
習熟フェーズに連動要約の技能は4つの操作に分解でき、この順に発達する。始めたばかりの人に「自分の言葉で中心を書く」(創出)を求めても届かないため、フェーズごとに要求する操作を変えている。
Brown, A. L., & Day, J. D. (1983). Macrorules for Summarizing Texts. Journal of Verbal Learning and Verbal Behavior, 22, 1-16.答案ごとに具体的な目標を立て、達成を判定する
執筆前と採点後「よく書け」ではなく「この答案で反論への応答を1段落入れる」のような具体的な成果目標を持たせる介入は効果量 0.70。達成度は点数に含めない — 評価対象にすると、達成しやすい安全な目標を選ぶようになるため。
Graham, S., & Perin, D. (2007). Writing Next. Carnegie Corporation.書き方を「何を・なぜ・例」で示す
執筆画面方略指導は、手順の名前を教えるだけでは足りず、目的と利点を述べ、実際に書いて見せ、習熟に応じて支援を外していく段階が要る。方略名だけを出す形から、なぜ効くかと書き出しの例まで出す形に変えた。日本語の小論文で教える中身は英語のジャンル要素と別物のため、5軸に対応させて作り直している。
De La Paz, S., & Graham, S. (2002). Explicitly Teaching Strategies, Skills, and Knowledge. Journal of Educational Psychology, 94(4), 687-698.複数の資料を関連づけて読む設計
総合問題対策複数資料の読解では「誰が・どの立場から言ったか」の把握と、資料をまたいだ内容の統合が別の能力として働く。実際の総合問題3件(早稲田政経・早稲田社会科学・慶應SFC)を読み合わせたところ、図表の有無や記述量は学部と年で大きく変わる一方、複数資料の関連づけだけは3件すべてで問われていた。
OECD (2019). How does PISA define and measure reading literacy? PISA in Focus #101.効果量をそのまま成果として約束しません。上記の効果量は英語圏の中高生を対象とした研究の値です。日本語の小論文で同じ数字が出る保証はありません。 また Writing Next の効果量一覧は報告書自身が「介入のメニューであって順位表ではない」と述べています。
日本語の作文指導には、英語圏に相当する規模のメタ分析が見つかりませんでした。 上記は枠組みを日本語の小論文に翻案したもので、 翻案の妥当性そのものは今後の検証課題です。
引用元・実装箇所の対応、および検証に使った資料は開示請求できます。 sakumon2026@gmail.com
私たちが目指すこと
「受かるまで」じゃない。
「通えるまで」。
小論文で合格できても、学費が壁になって進学を諦める——それでは「お金をかけられる子だけが進学できる」構造は変わりません。 私たちが本当になくしたいのは、その壁です。
だからEssAIは、合格の先にある奨学金小論(JASSO給付型・大学独自・民間奨学金)の作成サポートまで見据えて開発を進めています。 入試を突破するだけでなく、お金を理由に進学を諦めないところまで。それが、教育格差をなくすという私たちのミッションです。
奨学金小論サポート — 開発中 / Coming soon本番で気づく前に、
今、実力を正確に。
月3回の採点が永続無料。クレジットカード不要で今すぐ始められます。
iPhone・iPad アプリ(無料)を App Store で見る塾・予備校・個人指導の方は 法人プラン をご覧ください