AIモデルの選択が、採点の厳しさを決める。
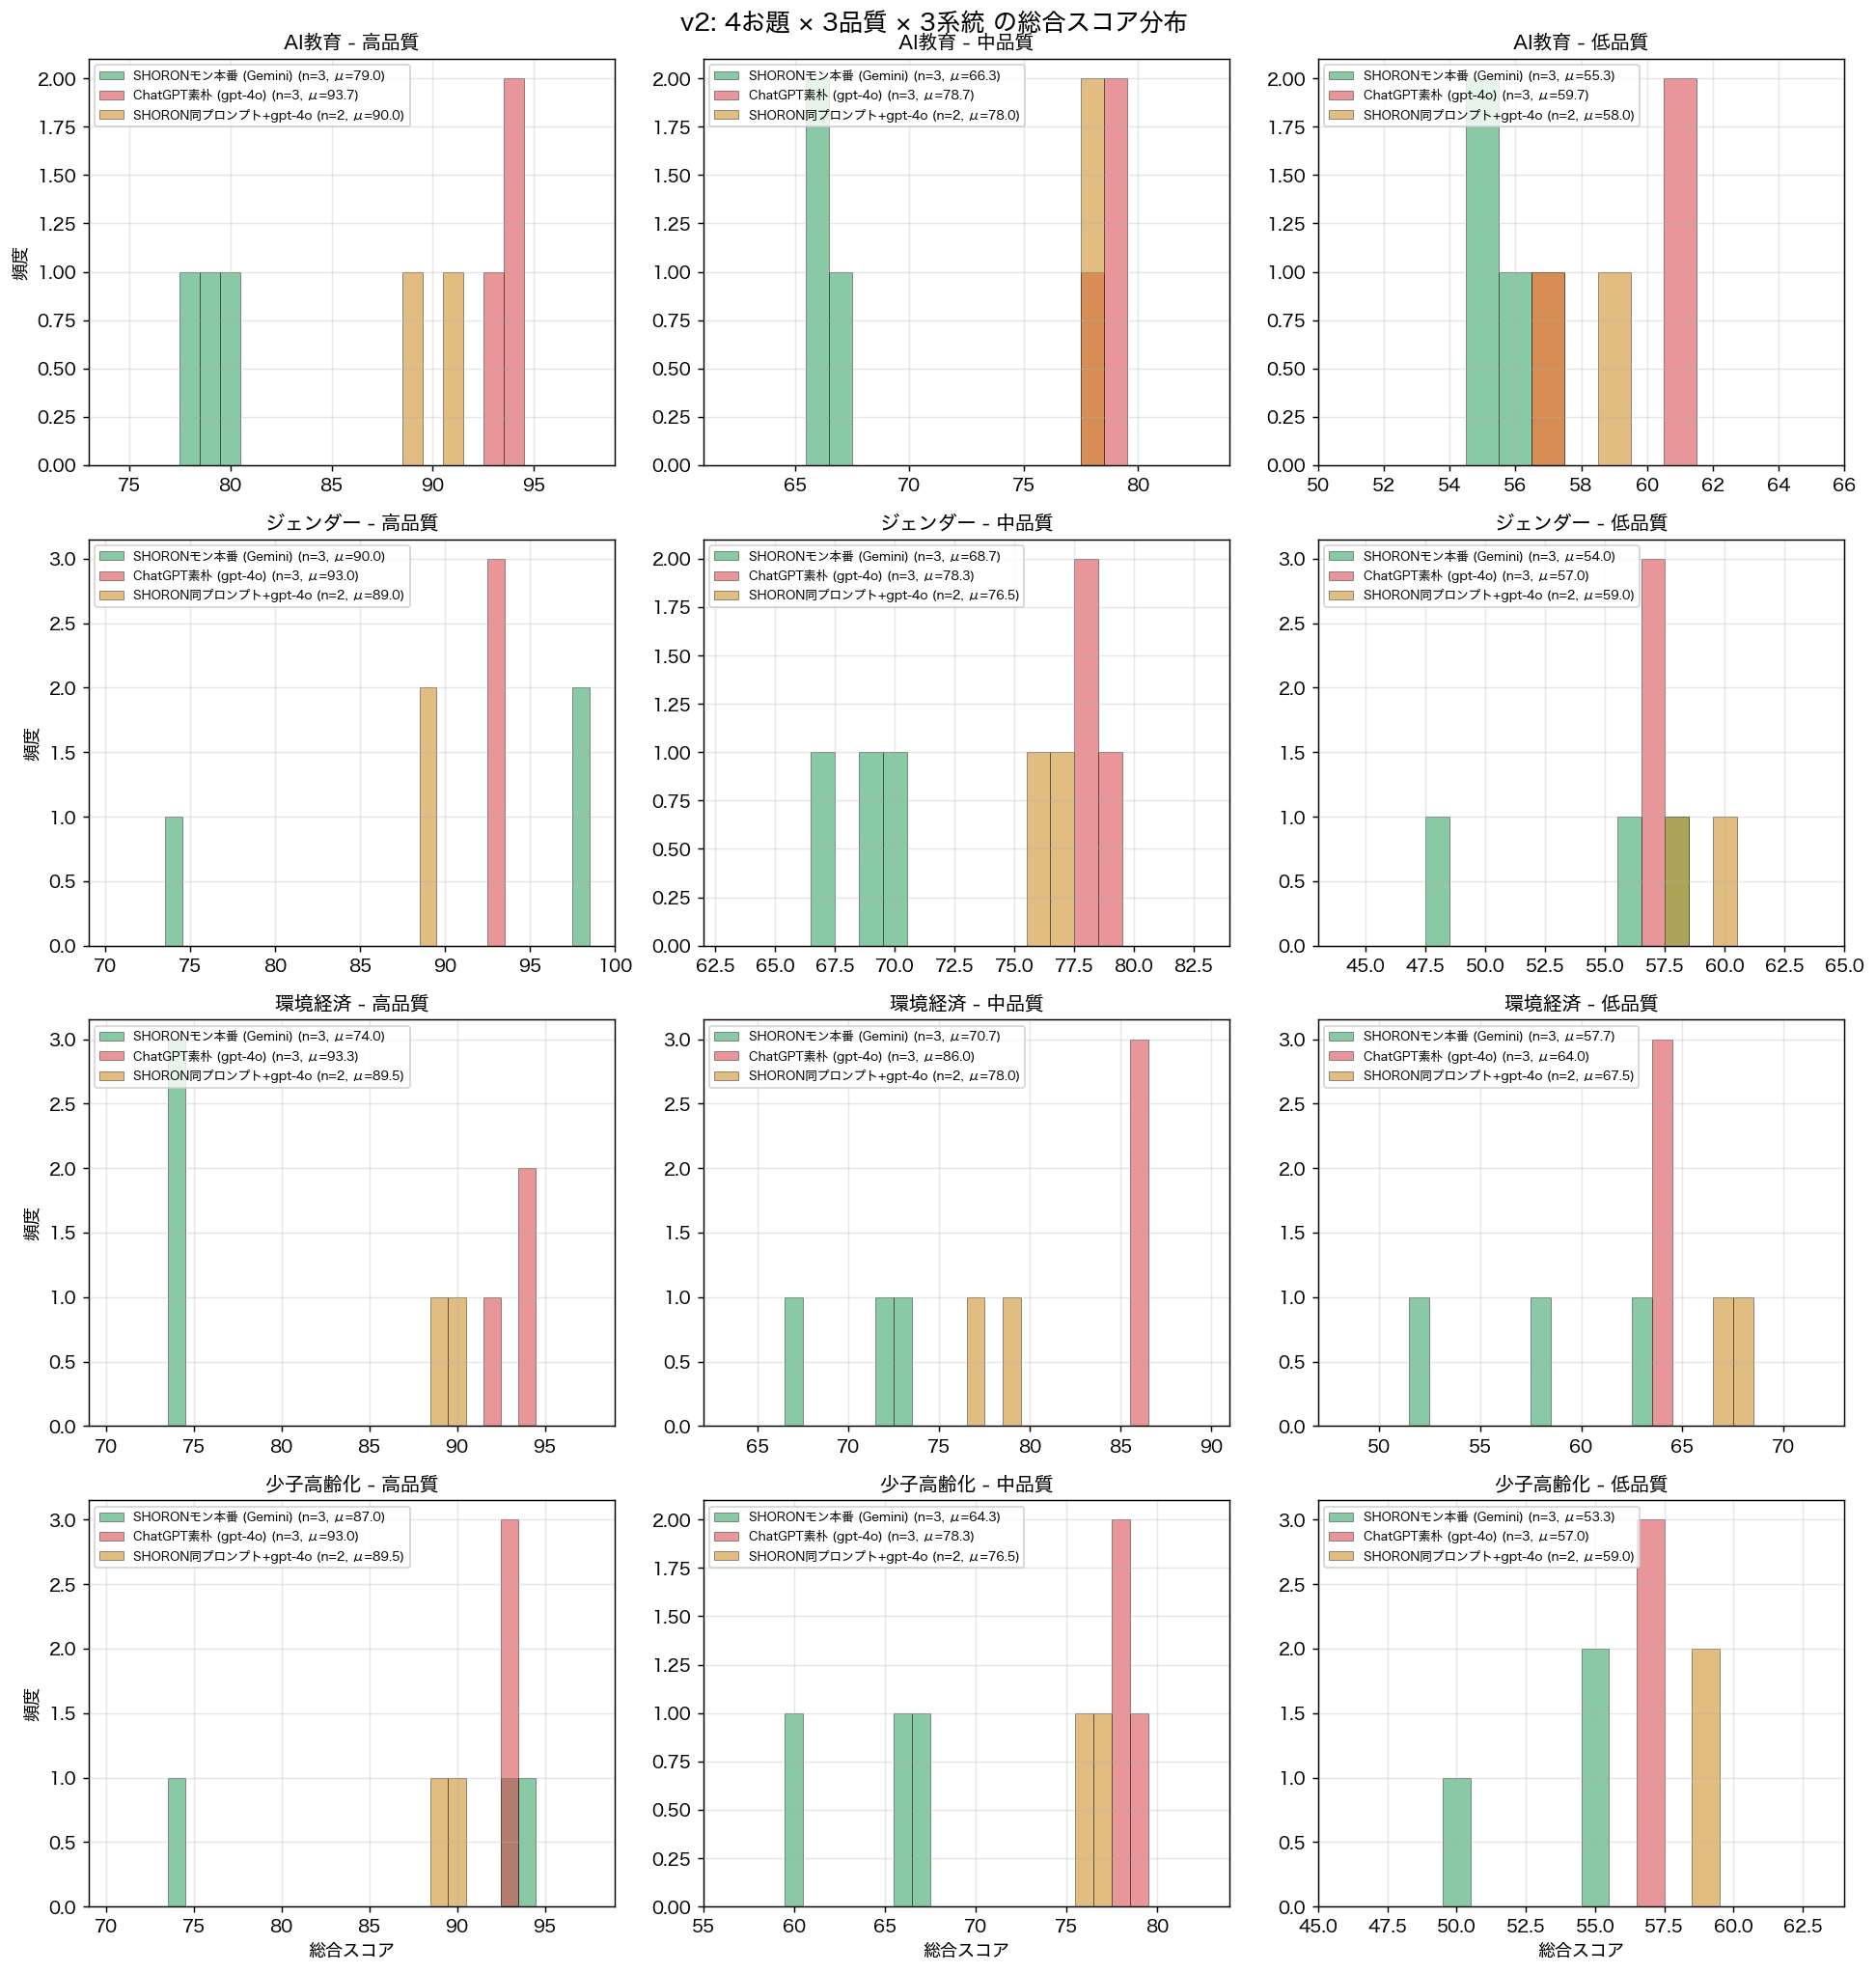
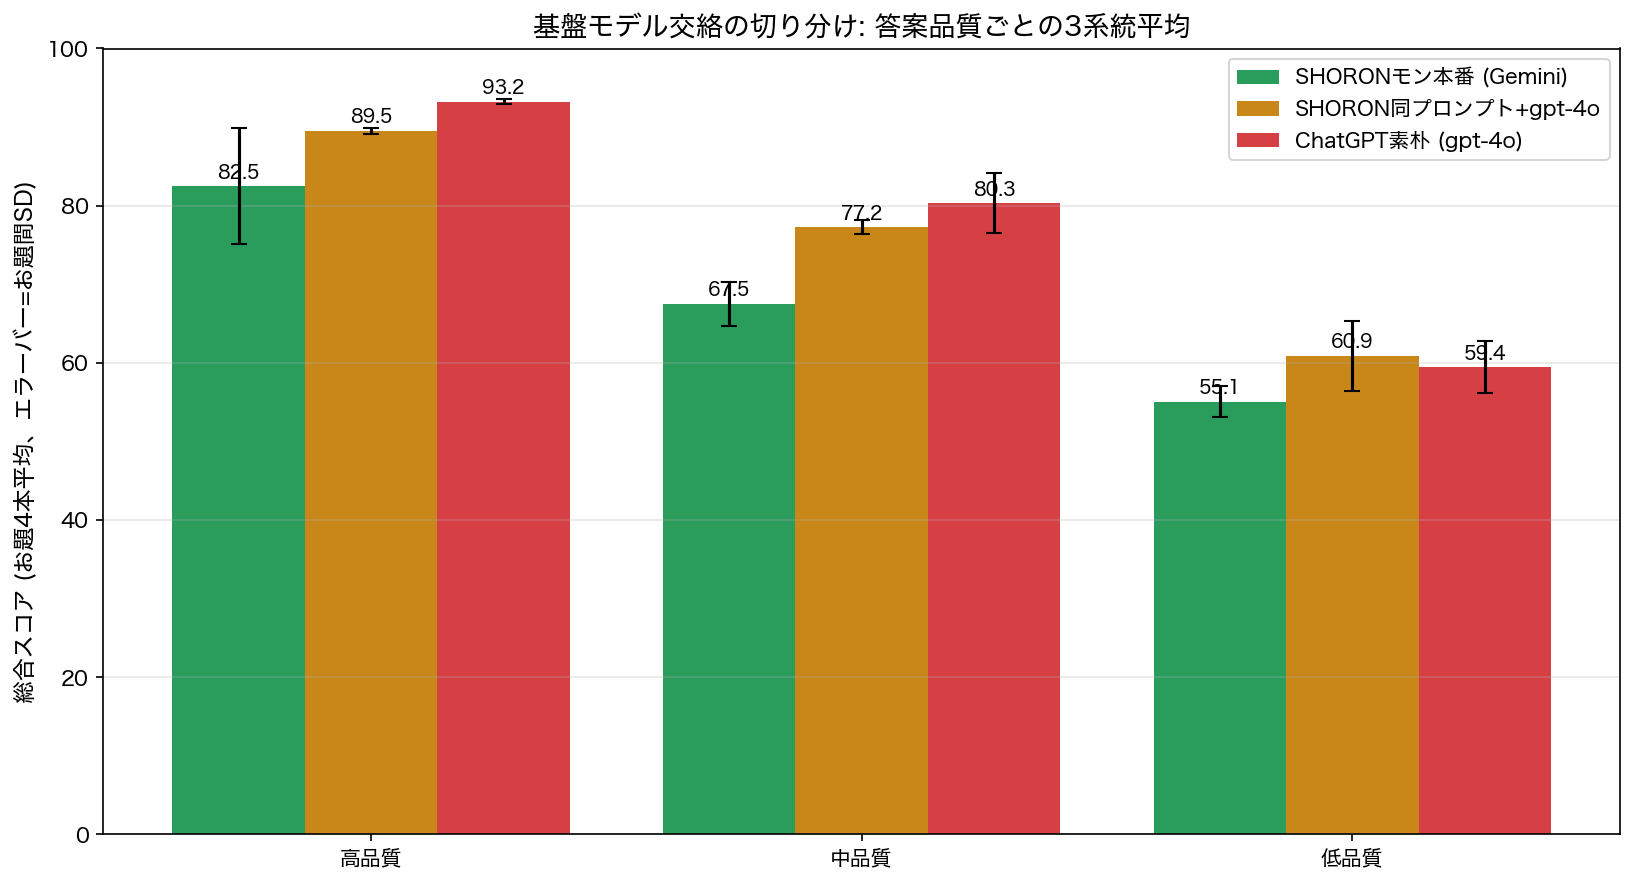
gpt-4o ベースのAI採点ツールは、同じ採点指示を出しても中品質答案を約9-10点甘く評価します (当社実測 d=3.62)。EssAIは教育用途で Gemini を採用、入試本番に近い厳しい評価を提供します。
Issues
塾長が抱える、3つの課題
採点者依存のスコアブレ
同じ答案でも採点者によってスコアが揺れる。生徒の実力を客観的に把握しづらく、保護者への説明も難しい。
教師の採点工数が膨大
月100生徒の小論文採点には塾長工数 5-8時間/月 が発生 (当社想定値)。本来は指導や教材改善に使いたい時間が、採点で消費される。
保護者への合格率説明が難しい
「うちの子は大丈夫?」という保護者の不安に、定量的な根拠で応えたい。AI採点が甘いと、本番との乖離が問題になる。
Technical Insight
AIモデル選択が、採点を変える。
当社検証で、同じ採点プロンプトでも Gemini と gpt-4o では中品質答案で約10点の差が発生することが判明しました (n=36, Cohen's d=3.62)。既存のAI採点ツールが gpt-4o ベース (Azure OpenAI Service 等) なら、生徒は甘く評価される可能性があります。
Design
EssAIの3つの技術設計
教育用途で Gemini を選択
同じ採点プロンプトでも、Gemini と gpt-4o では中品質答案で約10点の差が発生 (実測 d=3.62)。EssAIは教育用途で Gemini を採用し、入試本番に近い厳しい評価を実現します。
2回サンプリング+平均化
本番採点フローでは2回並列サンプリング+平均化を行い、差分が大きい場合は3回目+中央値で補正。同一答案30回採点での総合σ ≤ 2.14pt (※採点ブレは答案によって両者で逆転するため、訴求軸としては使用していません)。
5軸独立評価ルーブリック
論理構成・根拠・表現力・課題適合性・独自性の5軸で独立採点。各軸ごとの具体的な改善点を提示し、講師が指導の優先順位を判断できます。
Operational Comparison
運用工数比較 ── 月100生徒シナリオ
| 工程 | ChatGPT 手動 | EssAI |
|---|---|---|
| 採点プロンプト準備 | 毎回手動貼付 | 不要 (最適化済) |
| 100名分の貼付・実行 | 200分 | 0分 |
| 結果整形・記録 | 100-300分 | 0分 (自動) |
| 生徒への送付 | 100分 | 0分 (自動) |
| 履歴管理・成長可視化 | 手動Excel | 自動ダッシュボード |
| 採点にかかる工数 | 5-8時間/月 | 0分 |
塾長の時給を ¥3,000 と仮定すると、年間 ¥180,000〜¥288,000相当 の人件費削減 (想定値)。 さらに、削減した時間を本来の指導や教材改善に振り向けることができます。
※ 上記工数は想定値です。実際の運用で増減する可能性があります。
Features
B2B 専用機能
教室管理ダッシュボード
生徒一覧・採点履歴・成長推移を一画面で確認。複数講師のアカウント管理にも対応。
生徒招待・進捗可視化
参加コードを配るか、名簿に登録して招待リンクを送るだけ。フェーズ別の成長曲線を可視化し、指導方針を素早く判断。
5軸別の弱点分析
生徒ごとに「論理構成が弱い」「独自性が安定して高い」など、軸別の強み・弱みを自動分析。
Onboarding
導入フロー
無料トライアル
2週間・全機能
ROI試算
貴塾の生徒数で工数削減効果を試算
契約・導入
参加コードか招待リンクで生徒登録1分
運用サポート
メールサポート・優先対応
FAQ
よくあるご質問
Q.既に学校でAI採点ツール (Azure OpenAI ベース等) を導入しています。▼
多くの既存ツールは Azure OpenAI Service (gpt-4o) を採用しています。当社実測では、gpt-4o ベースのツールは標準的な採点指示でも中品質答案を9-10pt甘く評価する傾向があります (n=36, d=3.62)。生徒が「合格圏内」と表示されても、入試本番との評価ギャップが発生する可能性があります。EssAIは教育用途で Gemini を採用しているため、本番に近い評価を実現します。既存ツールとの併用導入も可能です。
Q.ChatGPT で生徒に採点させれば十分では?▼
当社検証で、ChatGPT素朴採点は中品質答案を約13点甘く評価します (Cohen's d=3.78, p<0.001)。また、月100生徒の手動運用には塾長工数 5-8時間/月 が発生します (想定値)。EssAIは同じ運用を 0分 で完了します。
Q.赤本AI とどう違うのですか?▼
赤本AI (教学社×みんがく) は、書籍に収録された問題に対するAI診断ツールです。EssAIは Web プラットフォームで、生徒自身が志望校の過去問を入力して未来問演習ができます。赤本AI で基礎を固め、EssAIで志望校特化の演習に進むという併用も可能です。
Q.AI採点の精度はどれくらい確かですか?▼
EssAI本番フローの採点再現性は σ≤2.14pt (100点満点中、同一答案30回採点)、5軸個別では σ≤1.17pt です。検証プロトコル・生データ・スクリプトを全て公開しており、第三者機関・研究者による再検証を歓迎します (sakumon2026@gmail.com)。
Q.未来問の検証規模 (n=17) は少なくないですか?▼
ご指摘の通りパイロット規模です。2027年度内に n=50+ への拡張検証を予定しており、データの濃い 3 校追加・各校 5-7 trial に拡張します。現時点でも (1) 思考スキル一致度 8.37 / 10、(2) 全 17 試行で 5 点以上を達成、(3) 当社採点モデル (Gemini) と独立した第三者AI (Claude Sonnet) による盲検評価で自社バイアスを排除、という事実は確認できています。検証スクリプト・生データは開示請求対応です。今後、人間講師との相関係数測定 (r > 0.7 を目標) も予定しています。
Q.無料トライアルはありますか?▼
はい、2週間の無料トライアルをご用意しています。教師プラン・教室プランどちらでも、契約前に全機能をお試しいただけます。
Q.導入後のサポートは?▼
教師プラン・教室プランともにメールサポート対応です。教室プラン以上は優先サポート対象。100名以上の大規模導入は個別ご相談をお受けします。